엔비디아가 CUDA 13.1 업데이트를 통해 새로운 프로그래밍 모델인 CUDA Tile을 공식 발표했다.
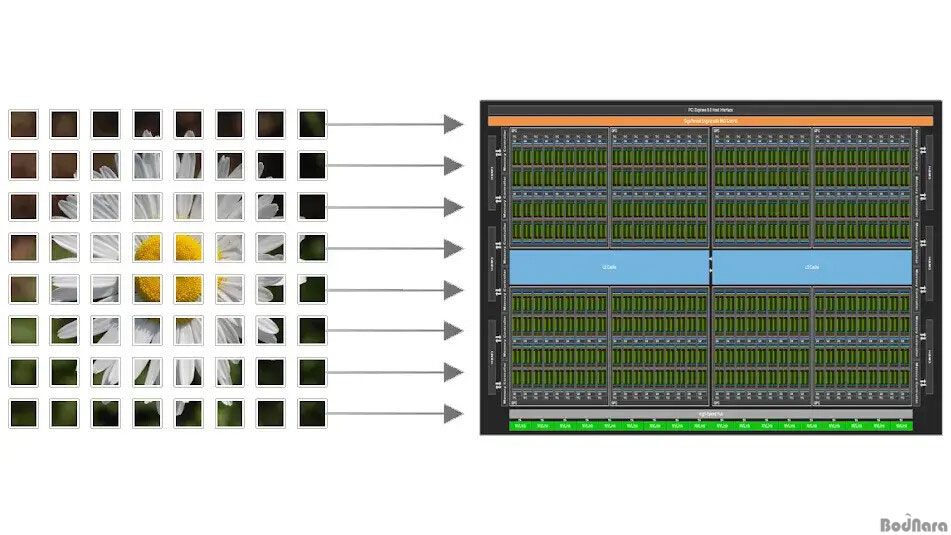
CUDA Tile은 기존 CUDA가 스레드와 블록 단위로 병렬 연산을 구성하던 SIMT 방식 대신, 데이터 덩어리인 타일(tile) 단위로 작업을 정의하는 구조를 도입한 것이 핵심이다. 개발자는 복잡한 스레드 인덱싱이나 메모리 접근 최적화를 직접 처리할 필요 없이, 타일 기반 연산 로직만 작성하면 나머지 작업은 컴파일러와 런타임이 자동으로 최적화해 GPU 하드웨어에 배치한다.
타일 연산을 위한 전용 중간 명령 구조인 Tile IR도 새롭게 추가됐다. 이를 통해 한 번 작성한 타일 기반 코드는 차세대 GPU 아키텍처에서도 재활용할 수 있어, 하드웨어 변화에 대한 개발 부담이 크게 줄어들 전망이다. 여기에 Python 환경에서 타일 기반 커널을 작성할 수 있는 cuTile 지원도 포함되면서 GPU 가속에 익숙하지 않은 개발자도 손쉽게 사용할 수 있는 진입 장벽 완화 효과가 기대된다.
행렬 연산과 반복 처리 구조가 많은 작업일수록 타일 단위 최적화가 자연스럽게 적용되기 때문에, CUDA Tile 도입으로 가장 큰 변화를 체감할 분야는 AI, 머신러닝, 데이터 분석과 같은 텐서 연산 중심 워크로드가 될 것으로 예상된다.
다만 모든 작업에 타일 방식이 적합한 것은 아니다. 복잡한 분기 구조나 비정형 데이터 처리처럼 세밀한 제어가 필요한 워크로드에서는 기존 CUDA 프로그래밍 모델이 유리할 수 있어, CUDA Tile과 기존 방식은 당분간 공존 체제를 유지할 것으로 보인다.
업계에서는 CUDA Tile이 엔비디아 GPU 생태계 확장을 가속하고, 향후 개발 언어 및 라이브러리가 타일 단위 구조로 재편되는 계기가 될 가능성에 주목하고 있다. GPU 프로그래밍의 난이도를 낮추면서 AI 연산 최적화까지 노린 전략이기 때문에, 관련 시장에 미칠 파급력은 상당할 전망이다.
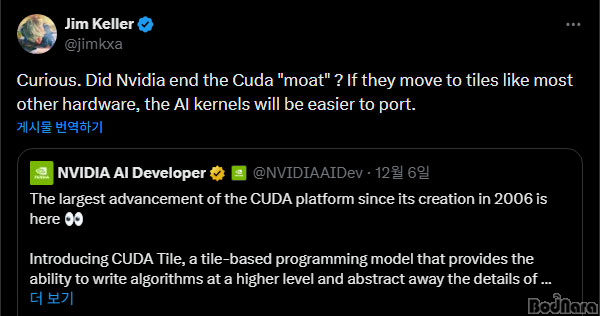
실제로 짐 켈러는 CUDA 타일을 통해 AMD 등 다른 GPU로의 코드 포팅이 훨씬 쉬워질 것이린 기대를 나타냈는데, 이는 타일링 방식이 업계에서 널리 사용되어 Triton과 같은 프레임워크에서 사용되고 있기 때문이다. 또한 추상화 수준을 높이면 개발자는 더 이상 아키텍처별 CUDA 코드 작성에 대한 걱정을 덜고 코드 포팅이 훨씬 쉬워질 것으로 예상된다.
단지, 포팅은 더 쉬워질 수 있지만 Tile IR과 같은 CUDA Tile의 기반이 되는 독점 기술이 NVIDIA 하드웨어 시맨틱에 최적화되어 있기 때문에 궁극적으로 CUDA Tile은 NVIDIA의 입지를 강화 시켜줄 것으로 전망된다.
|







 [영상] ASUS의 창신메모리 호환성 지원이 미치는 영향 등, PC시장 흐름 파악에 필요한 작은 뉴스모음