엔비디아가 AI 모델 훈련용 데이터 확보 과정에서 불법 복제 도서 유통 사이트와 접촉했다며, 저작권 침해 혐의로 다수의 저자들이 집단 소송을 제기했다.
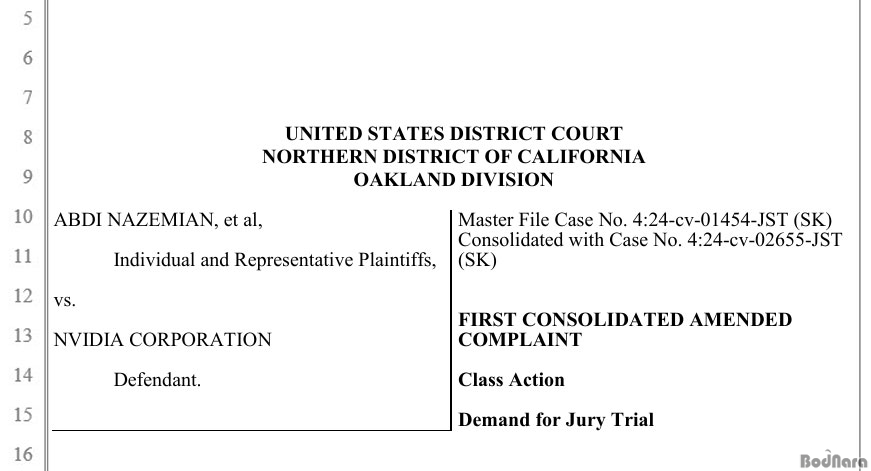
소장에 따르면 엔비디아 내부 관계자가 대규모 불법 복제 자료를 보유한 온라인 아카이브와 직접 연락해 데이터 접근 가능 여부를 문의했으며, 해당 자료를 AI 사전 학습(pre-training) 데이터로 활용하려 했다는 내용이 포함됐다. 이 과정에서 수백만 권 규모의 전자책 데이터가 제공 대상에 포함됐다는 주장도 함께 제기됐다.
소송 내용에 따르면 엔비디아는 해당 데이터가 불법 복제물이라는 점을 인지한 이후에도 접근 시도를 중단하지 않았으며, 내부 승인 절차를 거쳐 데이터 확보를 추진했다는 의혹까지 받고 있다. 원고 측은 엔비디아가 AI 모델 학습을 위해 합법적인 라이선스 기반 데이터가 아닌 불법 유통 자료에 접근하려 했다는 점을 핵심 혐의로 제시하고 있다.
이번 사안의 핵심은 불법 복제 콘텐츠를 AI 학습 데이터로 활용하는 행위 자체의 위법성이다. 단순히 공개된 데이터를 수집하는 차원을 넘어, 불법 복제물임을 인지한 상태에서 체계적으로 접근 및 활용하려 했다는 점이 사실로 확인될 경우, 저작권 침해 책임이 명확해질 수 있다.
또한, 스스로 업계를 선도하는 AI 기업임을 자부하는 엔비디아에서 위법한 방식으로 데이터를 확보하려 했다는 점은, AI 산업 전반의 데이터 윤리성과 신뢰성 문제로 확산될 가능성도 크다.
한편, 엔비디아는 과거 저작권 침해 관련 소송에서 학습 데이터 사용은 공정 이용이라는 입장을 밝혔으나, 이번 소송과 관련해서는 명시적인 입장을 밝히지 않았다.
|







 [영상] ASUS의 창신메모리 호환성 지원이 미치는 영향 등, PC시장 흐름 파악에 필요한 작은 뉴스모음