6. Hyper-Transport 대역폭 개선의 결과 
|
이번 페이지의 결과는
nForce3 150칩셋과 nForce3 250칩셋의 가장 큰 차이인 Hyper-Transport 부분의 대역폭 향상에 대해 어느정도
성능향상을 가져오고 있는지를 알아보기 위해 테스트를 진행했던 부분으로 3D랜더링 부분에서의 결과를 알아보자.
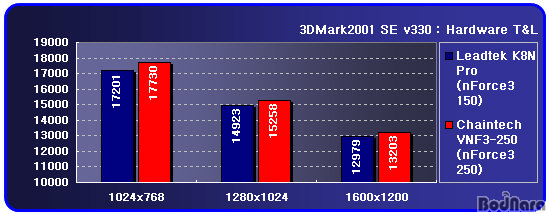 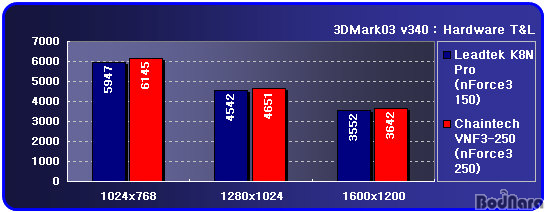
위의 두가지 테스트는
그래픽카드의 성능 테스트에 빠지지 않고 사용하는 3DMark2001 SE와 3DMark03의 테스트 결과인데 이 테스트는 모두
그래픽카드에서 지원하는 T&L 기능 및 Shader 연산을 사용하도록 설정하였기에 CPU연계되어 가장 많은 대역폭을 소비하는 AGP버스부분이라도
Hyper-Transport 대역폭의 향상이 성능에는 큰 영향을 주지 않을 것이다.
역시 결과에서도 nForce3
250칩셋이 기존 nForce3 150칩셋에 비해 3D랜러링시에도 성능향상이 있지만 그다지 큰 성능향상은 아닌 것을 알 수 있는데
Hyper-Transport 대역폭을 더 많이 소비하여 그 차이를 알기 위해 T&L과 Shader 연산을 CPU에서 담당하게 만드는
설정을 적용하여 테스트를 진행하였다.
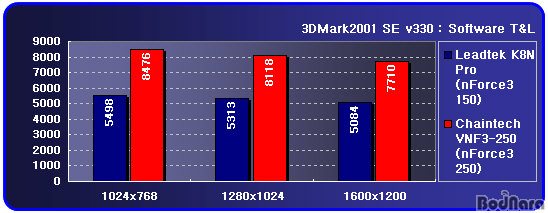 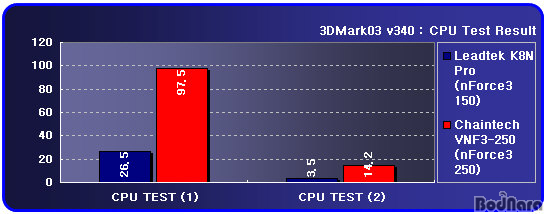
이것이 T&L 연산과
Shader 연산중 Vertex Shader 연산을 CPU부분에 담당시킨 설정들의 결과이다. 이 결과중 3DMark2001 SE
V330의 경우 DirectX 8.1세대의 테스트 프로그램답게 많은 부분이 T&L엔진에 의해 고정적인 부분으로 연산되고 CPU에 의한
연산부분이 많기에 Hyper-Transport 대역폭의 차이가 테스트 결과에 많은 영향을 주게 되는데 위의 그래프에서 알 수 있듯이
1024x768의 해상도에서 무려 3000점 정도의 차이를 나타내어 nForce3 250칩셋이 증가된 Hyper-Transport
대역폭의 성능 차이를 확연히 보여주고 있다.
그리고 그 밑의
3DMark03 CPU TEST부분도 Game Test 1과 Test 3 부분의 Vertex Shader 연산부분을 CPU에 담당하게
만들기에 그 차이가 확연하게 드러나는데 Pixel shader를 사용하지 않는 Test (1)부분은 Pixel Shader를 사용하여
그래픽카드 자체에서 연산되는 Test (2)보다 더 큰 차이를 나타내고 있다.
이처럼 nForce3 250칩셋인
Hyper-Transport의 동작클럭과 함께 CPU쪽으로 전송되는 데이터의 대역폭 또한 증가하여 Hyper-Transport 대역폭을
많이 소비하는 프로그램이나 연산쪽에서 기존 nForce3 150칩셋에 비해 성능향상 효과를 더 많이 가져오는데 그래픽 랜더링쪽과 함께
많은 데이터가 전송되어야 하는 HDTV 스트림 파일에 대한 인코딩에서도 어떤 결과를 가져오는 지를 테스트해 보았다.
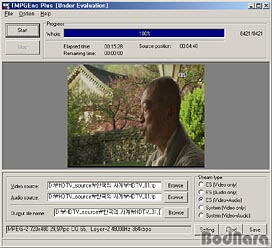
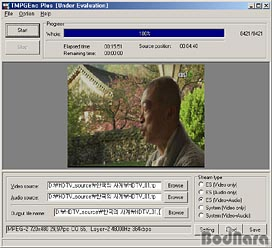
[ nForce3 250의
결과(좌), nForce3 150의 결과(우)]
테스트에 사용한 HDTV
스트림 파일은 약 600Mb상당의 데이터로 KBS의 한국의 미 방송의 일부분이다. 이 인코딩은 Divx 5 코덱으로 720x480
MPEG4 규격으로 인코딩하였는데 테스트 결과 nForce3 150 칩셋에서는 15분 51초가 걸린 것에 비해 nForce3 250
칩셋인 VNF3-250에서는 15분 28초가 소요되어 약 23초 정도 인코딩 시간이 단축되었다.
역시 예상했던데로의 결과이다. |
|

































