오픈AI는 제안서 초안 작성과 기술 도면 해석부터 양식 입력, 영상 편집까지 일상 업무 전반의 의사소통과 컴퓨터 기반 작업 역량을 강화한 AI 모델 ‘GPT-6.1 테라(GPT-6.1 Terra)’를 공개했다.
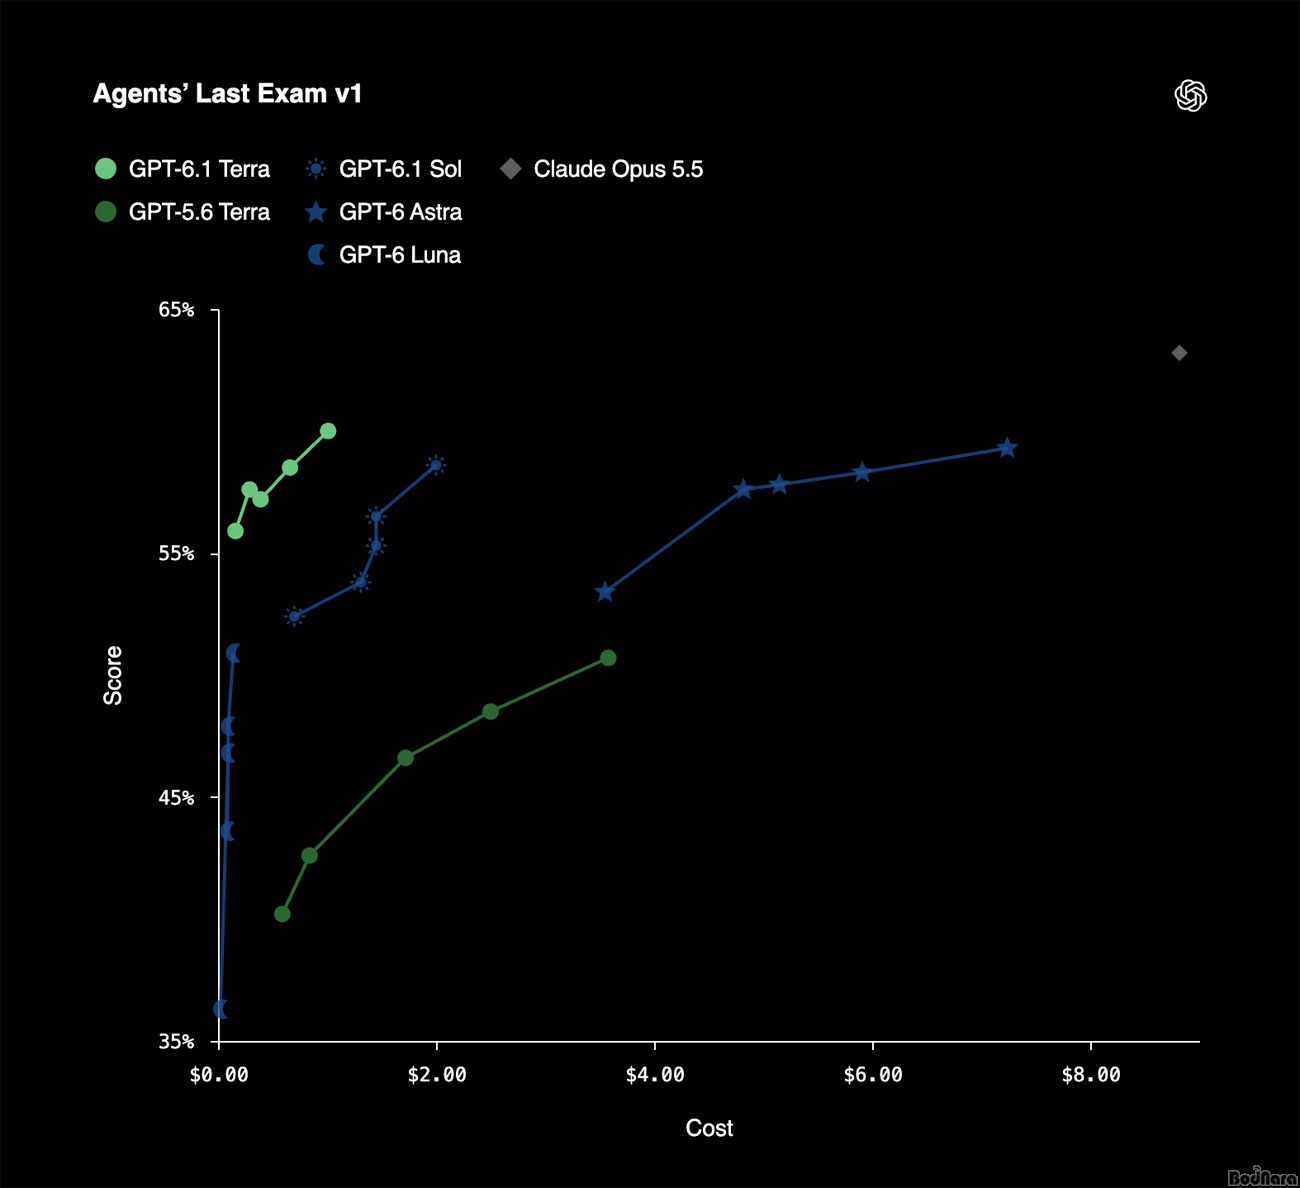
시각 추론과 컴퓨터 작업 수행, 글쓰기 능력을 결합한 이 모델은 대량의 업무를 빠르고 효율적인 비용으로 처리하도록 지원한다. 표준 API 가격은 GPT-5.6 테라와 GPT-6.1 솔보다 50% 낮으며, 챗GPT 워크(ChatGPT Work)와 코덱스(Codex), 오픈AI API를 통해 이용할 수 있다.
GPT-6.1 테라는 비용 대비 성능을 한층 높여 속도와 성능, 경제성을 두루 갖췄다. 표준 API 가격은 GPT-5.6 테라와 GPT-6.1 솔 대비 50% 낮게 책정됐다. 개발자는 이를 활용해 수신된 청구서의 내용을 읽고 세부 정보를 회계 소프트웨어에 입력하는 등 대량의 업무를 보다 낮은 비용으로 자동화할 수 있다. 챗GPT 워크와 코덱스에서도 동일한 사용 한도 내에서 더 많은 작업을 처리할 수 있다. 처리 가능한 작업량은 GPT-5.6 테라보다 늘었으며, GPT-6.1 솔이나 GPT-6 아스트라와 비교하면 증가 폭이 더욱 크다.
시각 정보 이해에서 작업 수행까지
컴퓨터 작업 수행 능력도 향상됐다. 건축 도면을 3D 모델로 변환하거나 애니메이션을 장면별로 검토해 복원팀을 위한 타임코드 기록을 작성하는 등 전문 업무로 구성된 ‘Agents’ Last Exam’에서 GPT-6.1 테라는 중간 추론 수준으로 GPT-5.6 테라보다 15%포인트 높은 점수를 기록했다. 비용은 약 3분의 1 수준이었다. GPT-6 아스트라와 비교해서는 토큰당 가격이 10분의 1 수준이면서 비슷한 성능을 보였다.
시각적 추론 평가인 MMMU-Pro에서는 모든 추론 설정에서 GPT-5.6 테라를 앞섰다. 데스크톱 앱을 활용한 다단계 작업 능력을 평가하는 OSWorld 2.1에서도 중간 추론 수준으로 GPT-5.6 테라의 최고 점수를 넘어섰으며, 작업당 비용도 낮았다.
사실 정확도와 코딩 성능의 대폭 개선
오픈AI는 올해 모델의 환각 현상과 사실 오류를 줄이는 데 집중적으로 투자해 왔다. 오류를 유도하는 질문으로 구성된 내부 평가에서 추론 수준을 낮게 설정했을 때 GPT-6.1 테라의 오류율은 16.7%로, GPT-5.6 테라의 53.6%보다 약 37%포인트 낮았다. 추론 수준을 최대로 설정한 경우에는 전작보다 18%포인트 낮은 4.3%를 기록해 GPT-6 아스트라와 GPT-6.1 솔에 가까운 수준을 보였다.
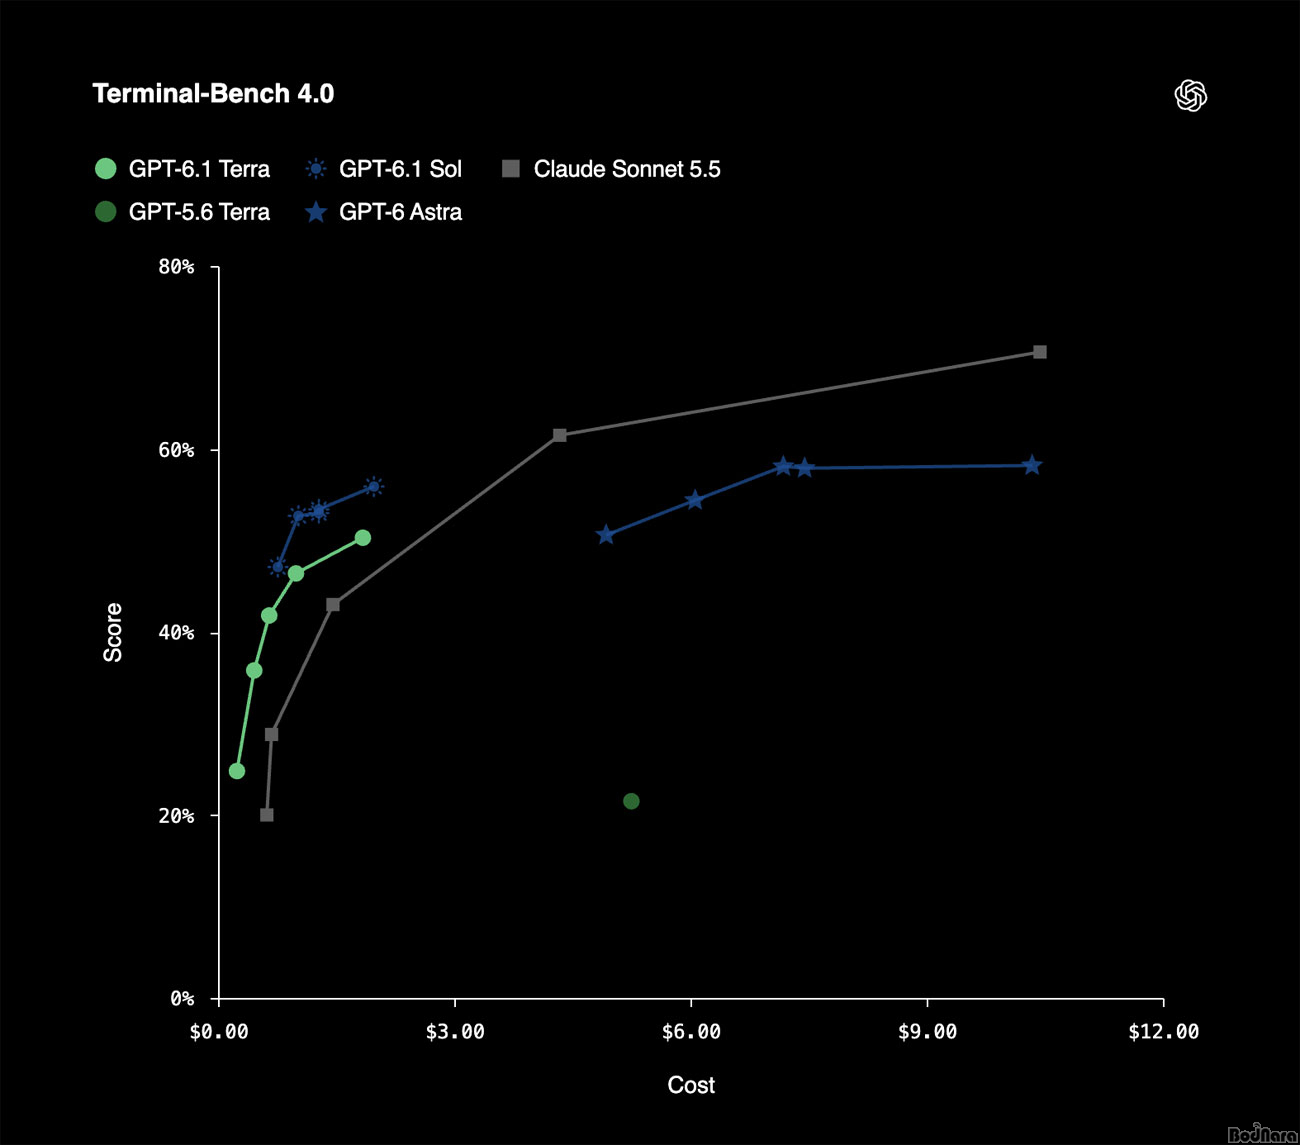
코딩 성능도 향상됐다. 명령줄 환경에서 코딩 에이전트의 문제 해결 능력을 평가하는 Terminal-Bench 4.0에서 GPT-6.1 테라는 최대 추론 수준으로 과제의 50.3%를 해결했다. GPT-5.6 테라의 공개 점수인 21.5%의 두 배를 넘는 수치다. 다만 오픈AI는 가장 복잡한 코딩 작업에는 GPT-6.1 솔과 GPT-6 아스트라가 여전히 더 적합하다고 설명했다.
안전성과 정렬(alignment)
오픈AI는 모델의 효율성을 높이는 동시에 안전장치를 학습·시험하고 개선하는 작업도 이어가고 있다고 밝혔다. GPT-6.1 테라는 오픈AI의 대비 체계인 ‘Preparedness Framework’에서 사이버보안 역량의 ‘Critical’ 기준에 도달했다. 오픈AI는 GPT-6 아스트라에 적용된 안전장치를 GPT-6.1 테라에도 적용한다.
오픈AI의 평가에 따르면 GPT-6.1 테라는 GPT-5.6 테라보다 사용자가 요청한 작업 범위를 더 잘 준수하고, 모델의 한계나 작업 진행을 가로막는 요인을 사용자에게 더 명확하게 알리는 경향을 보였다. 사용자의 작업에서 벗어나도록 유도하는 악성 지시에 대한 프롬프트 인젝션 시험에서도 높은 저항성을 나타냈다.
GPT-6.1 테라는 챗GPT 워크와 코덱스의 플러스·프로·엔터프라이즈·에듀 이용자에게 제공된다.


























